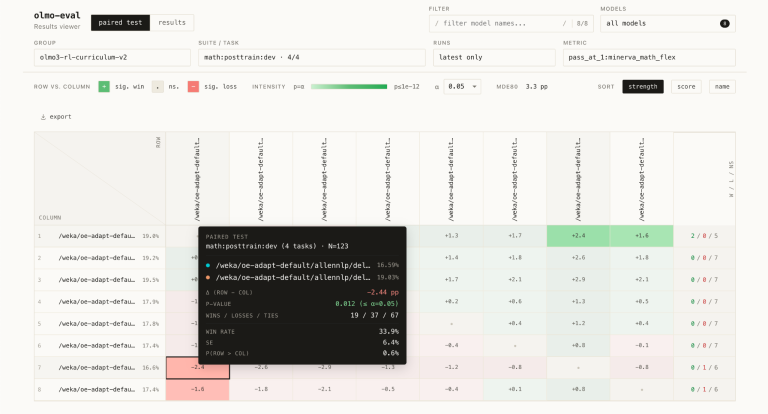
LLM 개발의 숨은 병목, ‘olmo-eval’이 해결하는 평가 루프의 진실
모델이 커질수록 평가는 더 복잡해집니다. 기존 도구들은 완성된 모델 검증에 치중해 개발 중 반복되는 변화를 따라가지 못했습니다. 올모이 올린 새로운 워크벤치가 개발 루프의 비효율을 어떻게 해소하는지, 그리고 왜 지금 주목받는…
JORE2
모델이 커질수록 평가는 더 복잡해집니다. 기존 도구들은 완성된 모델 검증에 치중해 개발 중 반복되는 변화를 따라가지 못했습니다. 올모이 올린 새로운 워크벤치가 개발 루프의 비효율을 어떻게 해소하는지, 그리고 왜 지금 주목받는…
단일 모델이 연기하던 시장 충격이 이질적인 5 개 모델의 공존에서 사라진 현상. AI 에이전트 간 상호작용이 어떻게 예측 불가능한 경제 행동을 만들어내는지, 그리고 그 이면의 기술적 함의를 분석한다.
생성형 AI 가 반복되는 루프에 갇히는 '텍스트 퇴화' 현상이 산업 현장의 걸림돌로 떠올랐다. 단순 지도 학습만으로는 해결되지 않던 이 한계를 DPO 가 어떻게 극복했는지, 그리고 왜 이 기술이 OCR 분야를 넘어 전 모델에…
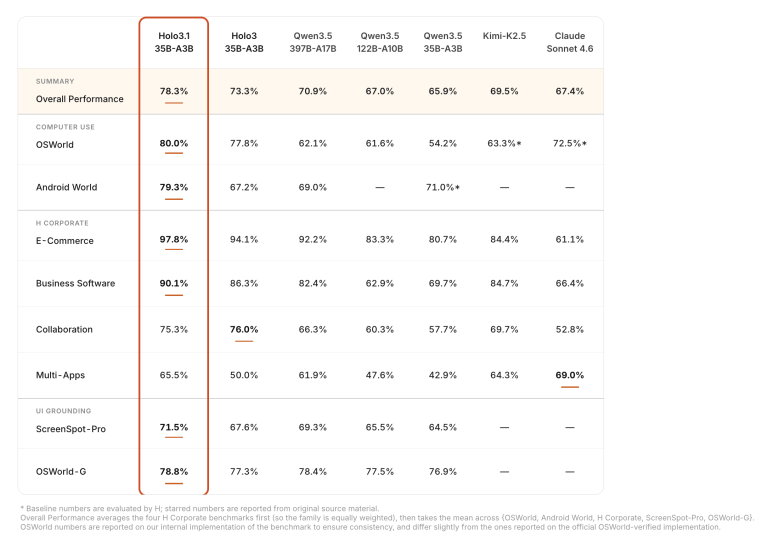
클라우드 의존을 넘어 사용자의 기기에서 바로 실행되는 AI 에이전트 시대가 열렸습니다. Holo3.1은 웹, 데스크톱, 모바일 환경을 아우르며 다양한 프레임워크와 호환되는 새로운 기준을 제시합니다.
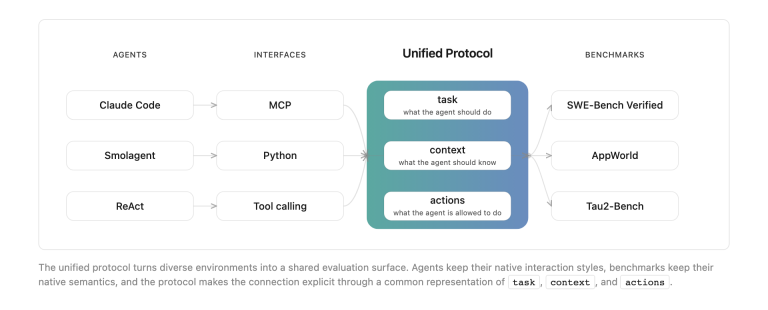
단순한 모델 점수 비교를 넘어 실제 배포 가능한 AI 에이전트 시스템의 전반성과 비용을 동시에 평가하는 새로운 기준이 등장했다. IBM 리서치가 주도한 이 프레임워크는 에이전트가 다양한 도구와 규칙 속에서 스스로 계획을 세우…
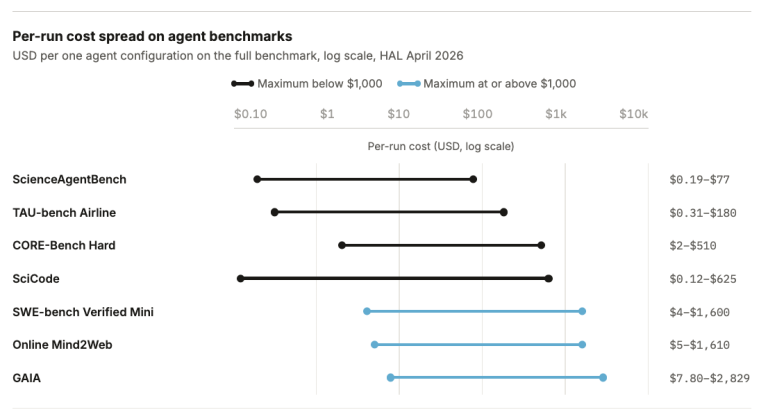
단순한 성능 측정을 넘어선 AI 평가의 비용 폭발. 에이전트 시대에 진입하며 평가 과정 자체가 가장 큰 컴퓨팅 리소스를 소모하는 단계로 변모하고 있다.