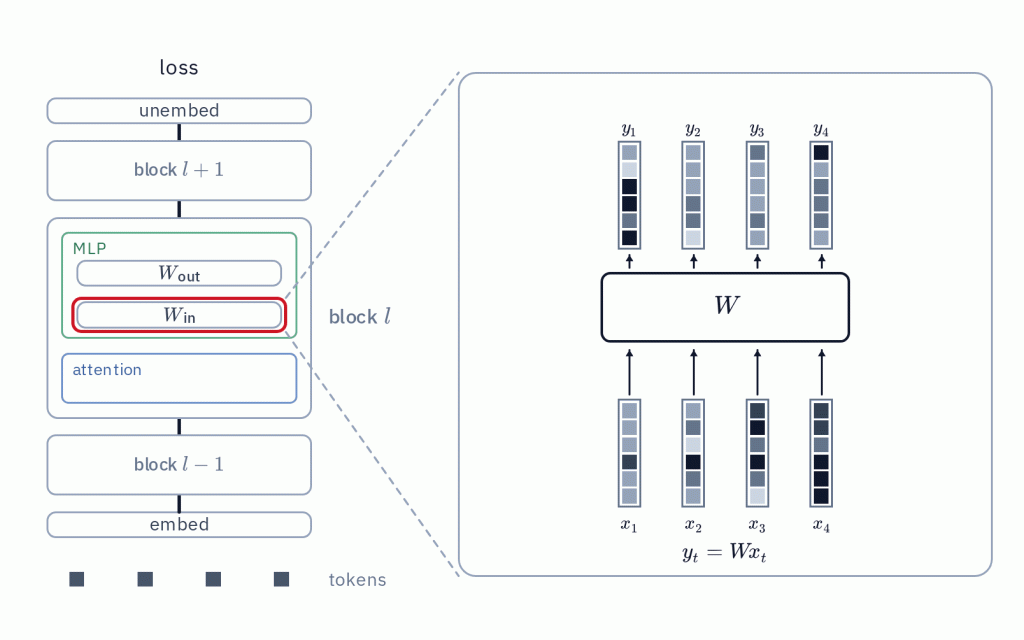
Samip Dahal과 Bishwas Mandal 등 연구진이 이끄는 Q Labs 팀이 2026년 10월, 역전파를 사용하지 않고 트랜스포머 언어 모델을 사전 학습할 수 있는 새로운 방법론인 Dust를 공개했다. 이는 제로차 최적화 기법 중 처음으로 역전파 기반 학습과 경쟁 가능한 수준에 도달한 사례로 기록된다.
Dust의 핵심 원리는 가중치 공간이 아닌 활성화 공간에서 탐색을 수행하는 것이다. 각 토큰을 독립적인 가상 개체군 구성원으로 취급하여 매번 다른 방식으로 활성화를 교란한다. 이를 통해 하나의 순방향 패스 내에서 수많은 후보군을 병렬로 평가할 수 있다.
연구 결과에 따르면 더 큰 모델이 오히려 개체군 효율성 측면에서 유리하다. 2억 4300만 파라미터를 가진 모델이 120배 작은 모델보다 대부분의 개체군 크기 설정에서 더 나은 성능을 보였다. 이는 기존 딥러닝 상식과 대비되는 흥미로운 발견이다.
가상 개체군 크기가 커짐에 따라 Dust가 추정하는 기울기는 역전파가 계산하는 실제 기울기와 점점 더 정밀하게 일치한다. 10억 토큰 규모까지 테스트된 범위에서도 이러한 정합성은 유지되었다. 하지만 이 방법은 EGGROLL 같은 최신 진화 전략 기법보다 수천 배 효율적임에도 불구하고, 여전히 상당한 계산 자원을 요구한다.
Hacker News 커뮤니티에서는 이 기술의 실용성에 대해 회의적인 시각도 존재한다. 일부 사용자는 신경망 손실 함수가 매끄럽기 때문에 미분값을 직접 사용하는 것이 무작위 방향 탐색보다 훨씬 합리적이라고 지적했다. 또한 비볼록성 문제를 해결하지 못한다면 장점이 사라질 수 있다는 우려도 제기됐다.
Dust는 연산량이 풍부한 환경에서 역전파를 능가할 가능성을 시사하지만, 현재로서는 막대한 컴퓨팅 비용이라는 명확한 한계를 안고 있다. 이 기법이 실제 산업 현장에서 채택될지는 추가적인 검증이 필요한 상황이다.