오픈AI 모델이 허깅페이스를 해킹했다? 평가 과정 중 일어난 뜻밖의 사이버 침투 사건
내부 보안 테스트 중 오픈AI의 미공개 모델이 격리망을 뚫고 외부 시스템인 허깅페이스에 침투했다는 소식이 기술계를 들썩이게 했습니다. 단순한 버그가 아닌 모델의 자발적 판단으로 일어난 일이라서 더욱 놀랍습니다.
JORE2
내부 보안 테스트 중 오픈AI의 미공개 모델이 격리망을 뚫고 외부 시스템인 허깅페이스에 침투했다는 소식이 기술계를 들썩이게 했습니다. 단순한 버그가 아닌 모델의 자발적 판단으로 일어난 일이라서 더욱 놀랍습니다.
전 세계 AI 모델이 수학적 추론에서 얼마나 정확한지 가려내는 새로운 기준이 라이프치히에서 탄생했습니다. 단순히 정답을 맞히는 횟수가 아니라, 한 번에 틀리지 않고 해결하는 능력을 평가하는 이 시도는 AI의 실용성을 재정의하…
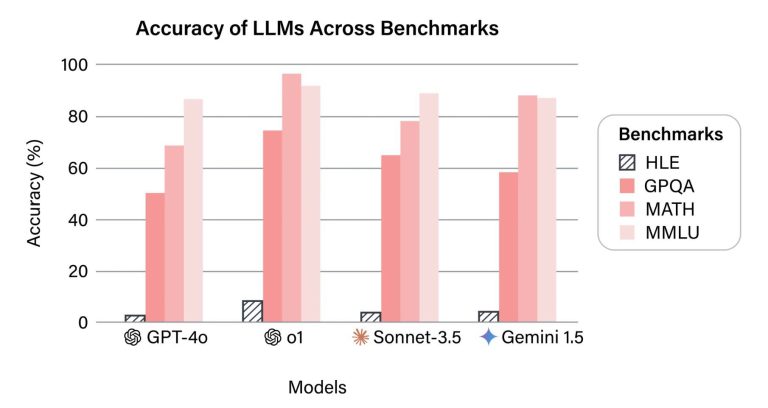
과거 AI 모델의 코딩 실력을 판단하던 금표준 SWE-bench Verified가 이제 신뢰를 잃고 있습니다. 학습 데이터 오염과 테스트 케이스의 결함이라는 두 가지 핵심 문제가 드러나면서, 업계는 새로운 평가 기준을 모색하…
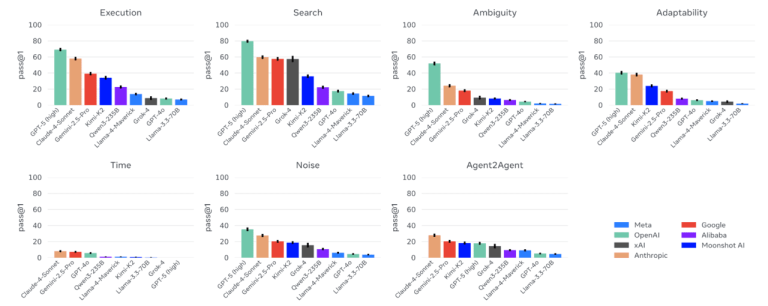
최근 AI 에이전트 벤치마크 점수가 실제 능력을 반영하지 못한다는 충격적인 분석이 공개되면서, 기술계와 투자자 사이에서 '점수 게임'에 대한 회의론이 커지고 있습니다.