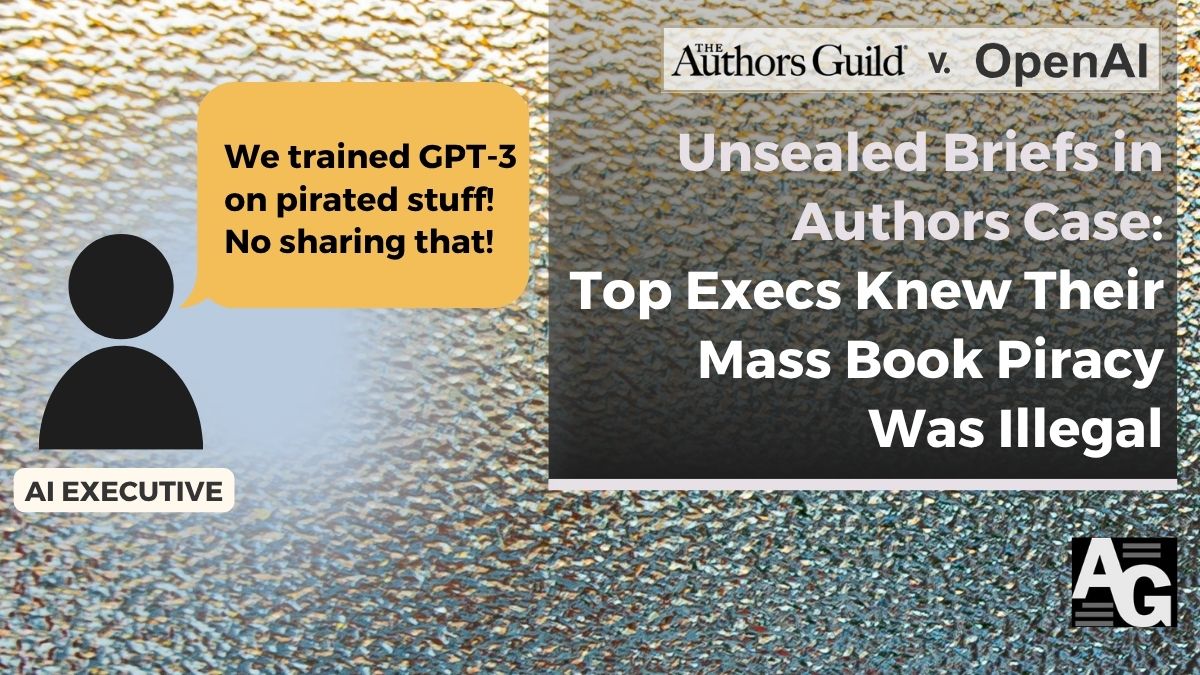
2026년 9월 21일 뉴욕에서 작가 단체와 마이크로소프트 및 오픈AI 간 저작권 침해 소송과 관련된 새로운 법원 문서가 공개되었습니다. 이번 봉인 해제된 서류에는 오픈AI 임직원들이 copyrighted 데이터를 무단으로 사용하는 것에 대한 법적 리스크와 대외적 이미지를 어떻게 평가했는지가 구체적으로 기록되어 있습니다.
특히 주목할 만한 부분은 2020년 7월에 작성된 오픈AI 직원 라이언 로우의 내부 메모입니다. 그는 LibGen이라는 웹사이트를 책 요약 프로젝트에 계속 사용하는 것의 위험성을 분석했습니다. 로우는 해당 데이터 출처에 대해 질문을 받을 가능성이 80퍼센트 이상이라고 판단했으며, 이에 대해 명확한 답변을 피할 수밖에 없는 상황을 예상했습니다.
로우의 메모에는 더 나아가 이러한 상황이 외부 인식에 미칠 영향도 언급되어 있습니다. 그는 약 40퍼센트의 확률로 moderate-sized Twitter kerfuffle 즉, 트위터에서의 소규모 논쟁이 발생할 수 있다고 보았습니다. 이는 오픈AI의 작업에 대한 부정적인 인상을 줄 수 있다는 우려에서 비롯된 것입니다.
또 다른 내부 인용문에서는 OpenAI Feared Optics of what might appear on Hacker News라는 표현이 등장합니다. 연구원은 sketchy russian website에서 저작권 데이터를 가져온다는 사실이 해커뉴스에 올라올 경우를 걱정했습니다. 이는 단순한 법적 문제가 아니라 기술 커뮤니티 내 평판 관리 차원의 고민이었음을 시사합니다.
이번 문서 공개는 오픈AI 측이 GPT-5 모델이 장르 소설 작가를 대체할 수 있다고 믿었으며, 이것이 공정 사용 정의상 법적 방어가 될 수 있다고 생각했다는 점도 함께 드러냈습니다. 하지만 실제 작가들은 자신의 작품이 보상 없이 모델 학습에 사용된 것에 분노하고 있을 뿐, AI가 자신을 완전히 대체한다는 두려움보다는 권리 침해를 더 크게 문제 삼고 있는 것으로 보입니다.
현재까지 확인된 사실은 오픈AI 내부에서 데이터 수집 과정의 투명성 부족과 이로 인한 사회적 반발 가능성을 사전에 인지하고 있었다는 점입니다. 향후 재판 과정에서 이러한 내부 의사결정 구조가 저작권법 위반 여부에 어떤 영향을 미칠지 귀추가 주목됩니다.
작성자 소개