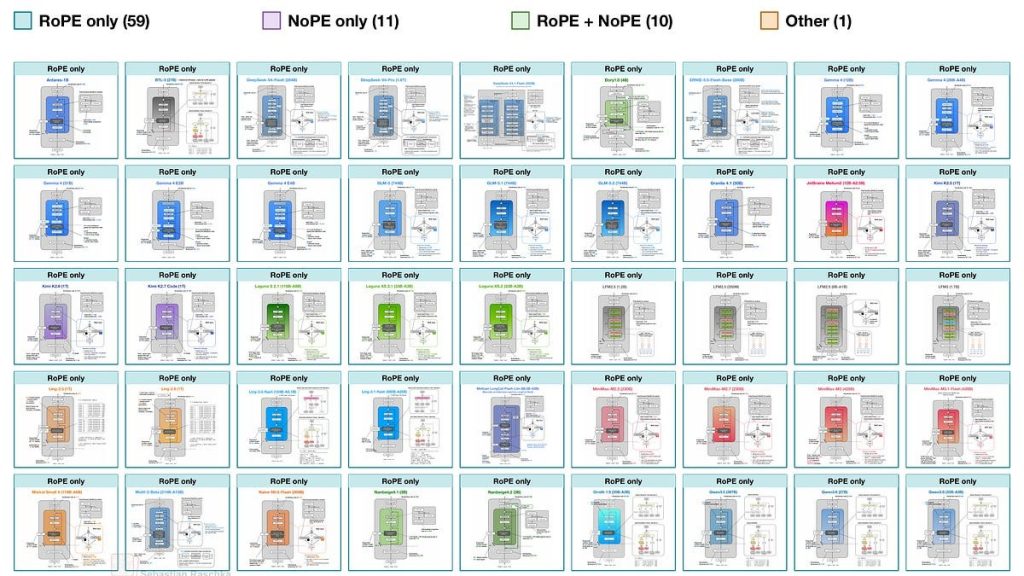
세바스찬 라슈카가 지난 15일 자신의 기술 블로그를 통해 2026년 출시된 주요 오픈 웨이트 대형 언어 모델들의 위치 인코딩 전략을 비교하는 심층 분석 글을 게시했습니다. 이번 보고서는 고전적인 아키텍처인 GPT-2와 최신 모델인 MiniMax-M3 사이의 기술적 차이를 명확히 구분하여 제시합니다.
라슈카는 텍스트 처리 과정에서 토크나이저가 입력 문장을 정수 ID로 변환한 뒤, 임베딩 레이어가 이를 벡터로 바꾸는 기본 흐름을 먼저 설명했습니다. 이후 이 벡터에 위치 정보가 어떻게 결합되는지 추적하며, 초기 모델들이 사용했던 학습된 절대 위치 테이블과 최근 트렌드인 상대적 위치 공식화를 대조했습니다.
특히 주목할 부분은 회전형 위치 인코딩(RoPE)이 어텐션 블록 내부에서 작동하는 원리입니다. 라슈카는 시각적 워크플로우와 수학적 공식을 활용해 RoPE가 토큰 간 거리 정보를 보존하면서 순서 의존성을 해결하는 방식을 구체적으로 보여줍니다. 이는 단순한 벡터 덧셈을 넘어 어텐션 레벨에서의 변환 과정을 포함합니다.
해당 분석에는 PyTorch 기반의 구현 예제가 포함되어 있어 개발자들이 이론적 개념을 코드 수준에서 검증할 수 있도록 돕습니다. GPT-2의 경우 명시적인 위치 벡터를 추가하는 방식이지만, MiniMax-M3 등 최신 모델들은 이러한 명시적 인코딩을 수정하거나 생략하는 다양한 변형을 채택하고 있습니다.
기술 커뮤니티에서는 이 글이 단순한 나열을 넘어 그룹 표현론 관점에서 위치 인코딩을 해석하는 시도를 담았다는 점에서 논의가 이어지고 있습니다. 한 사용자는 로터리 인코딩이 평행 이동 군의 표현이라는 점과 유클리드 군의 확장 가능성을 언급하며 이론적 깊이를 더했습니다.
이번 자료는 기계학습 엔지니어와 트랜스포머 실무자를 위한 참고 문서 성격이 강합니다. 다만 모든 오픈 소스 모델을 포괄하지는 않으며, 벤치마크 대상은 2026년 릴리스된 특정 모델들에 한정되어 있습니다. 향후 새로운 위치 인코딩 기법이 등장함에 따라 이 분류 체계가 얼마나 지속될지는 미지수로 남아 있습니다.