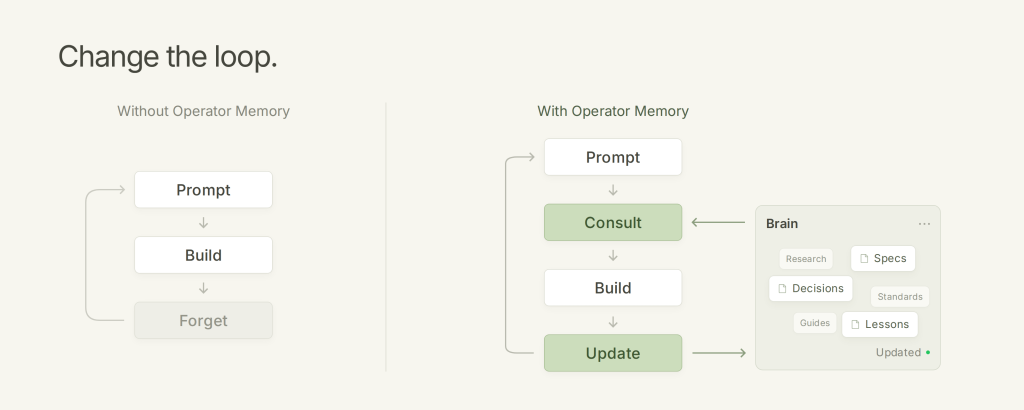
2026년 10월 3일, Yash Thakker가 작성한 에세이 Agents Don’t Need Memory. They Need Documentation.이 온라인 기술 커뮤니티에서 화제가 되었습니다. 이 글은 현재 널리 쓰이는 AI 코딩 에이전트의 메모리 플러그인 구조를 정면으로 비판합니다.
저자는 대부분의 메모리 기능이 대화 기록을 잘게 쪼개 벡터 데이터베이스에 저장하고, 프롬프트마다 유사도가 높은 스니펫 다섯 개를 주입하는 단순한 RAG 방식에 불과하다고 진단했습니다.
저자가 보기에 이런 접근법은 에이전트가 프로젝트를 이해하게 만드는 데 실패합니다. 사용자는 과거 대화의 파편을 복원하는 것이 아니라, 특정 기능이 왜 만들어졌고 어떤 합의가 있었는지 등 프로젝트의 맥락을 파악하길 원합니다. 하지만 유사도 검색은 임베딩 공간에서의 거리만 계산할 뿐, 정보가 정확한지 최신인지 혹은 누락된 부분은 없는지 판단하지 못합니다.
그 결과 에이전트는 혼란스러운 상태에 빠지고, 추가 검색 도구로 더 많은 토큰을 소모하며 문제를 해결하려 합니다.
대신 저자는 마크다운 형식의 문서를 체계적으로 관리하는 방식을 제안합니다. 이를 Operator Memory라는 오픈소스 플러그인으로 구현해 공개했습니다. CLAUDE.md나 MEMORY.md 같은 파일 습관을 확장해, 에이전트가 프로젝트의 영구적인 지식과 임시적인 노트를 명확히 구분하도록 유도하는 구조입니다.
이 방법은 벡터 검색의 불확실성을 줄이고 인간이 읽기에도 좋은 형태를 유지합니다.
해커뉴스에서는 해당 에세이에 대해 210점 이상의 점수와 112개의 댓글이 달리며 활발한 논의가 이어졌습니다. 일부 개발자들은 .agents/knowledge/ 폴더처럼 안정적이고 영구적인 지식을 별도로 관리하는 규칙을 공유하기도 했습니다. 반면 다른 사용자들은 단순히 문서를 작성하는 것만으로는 부족하며, 잘못된 코드 패턴을 방지하기 위해 린트 규칙이나 결정론적인 피드백 루프가 병행되어야 한다고 주장했습니다.
현재까지의 논의는 메모리 플러그인의 근본적인 아키텍처 결함을 지적하는 데 초점이 맞춰져 있습니다. 다만 문서화 중심의 접근법이 모든 규모의 프로젝트에서 동일한 효율성을 보장하는지, 또는 기존 벡터 기반 시스템과의 호환성 문제는 어떻게 풀어야 할지에 대한 구체적인 벤치마크 데이터는 아직 제시되지 않았습니다.