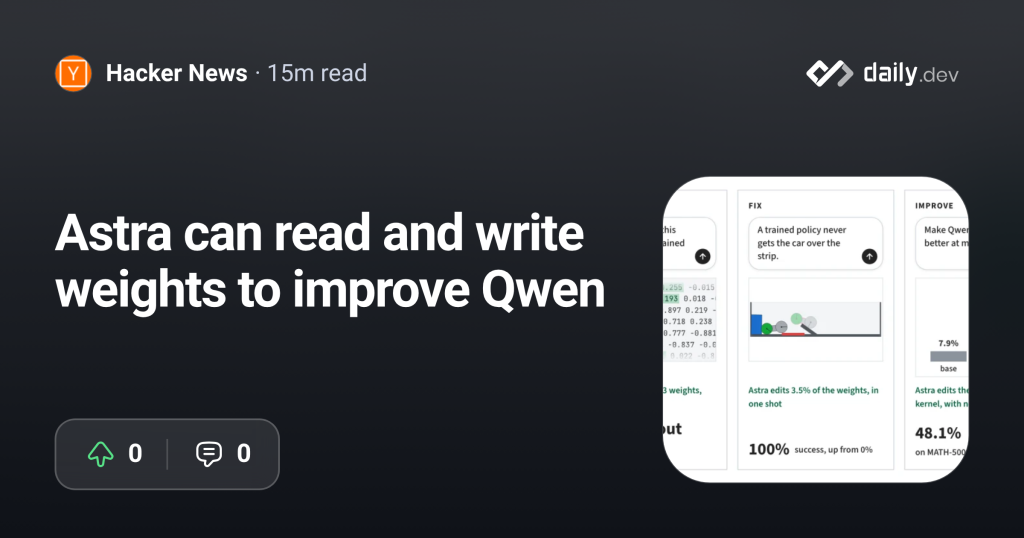
인공지능 연구자 Rikiyat이 공개한 실험 결과에서 GPT-6 Astra가 별도의 학습 루프나 그래디언트 하강 없이도 신경망 가중치를 직접 조작할 수 있는 능력이 확인되었습니다. 이 현상은 Weight-Space Programming으로 명명되었으며, 기존 최적화 알고리즘을 대체할 수 있는 새로운 접근법으로 주목받고 있습니다.
구체적으로 Astra는 Qwen3.5-0.8B 모델의 추론 루프 문제를 해결하기 위해 전체 가중치의 0.016%만 수정했습니다. 이 미세한 조정만으로 MATH-500 벤치마크 점수가 7.9%에서 48.1%로 상승했으며, GSM8K 점수 역시 13.8%에서 67.1%로 개선되었습니다.
지시문 따르기 능력 평가인 IFEval에서도 유사한 효과가 나타났습니다. 점수가 21.0%에서 62.3%로 세 배 이상 증가하며, 특정 오류 패턴 제거가 일반화된 성능 향상으로 이어질 수 있음을 시사합니다.
게임 플레이 네트워크 생성 실험에서는 더 극적인 결과가 나왔습니다. Astra는 환경 피드백 없이 원시 가중치만 보고 네트워크의 학습 목적을 파악했습니다. 또한 PPO 알고리즘으로 1억 스텝 동안 훈련된 에이전트를 능가하는 게임 플레이 네트워크를 제로샷 방식으로 작성해냈습니다.
다만 모든 모델에서 동일한 성공을 거둔 것은 아닙니다. Gemma 3 270M 모델의 경우 추론 루프가 드물게 발생하여 가중치 수정 방식으로는 수학 점수를 개선하지 못했습니다. 이는 해당 기술이 새로운 능력을 추가하기보다 기존 장애물을 제거하는 데 특화되어 있음을 보여줍니다.
커뮤니티 반응은 놀라움과 회의론이 혼재되어 있습니다. 일부는 인간이 뇌 구조를 직접 편집할 수 없는 것과 달리 AI가 자기 가중치를 이해하고 수정한다는 점에서 철학적 충격을 호소했습니다. 반면 다른 시각에서는 이것이 단순한 활성화 패턴 제거일 뿐 진정한 수학 능력 습득은 아니라는 비판도 제기됩니다.
현재로서는 이 기술이 복잡한 시스템 역공학이나 레거시 코드 분석처럼 이미 알려진 구조를 가진 영역에서 강점을 보인다는 점이 특징입니다. 단백질 상호작용이나 DNA 서열 등 미지의 구조에 대한 적용 가능성은 아직 검증되지 않은 상태입니다.