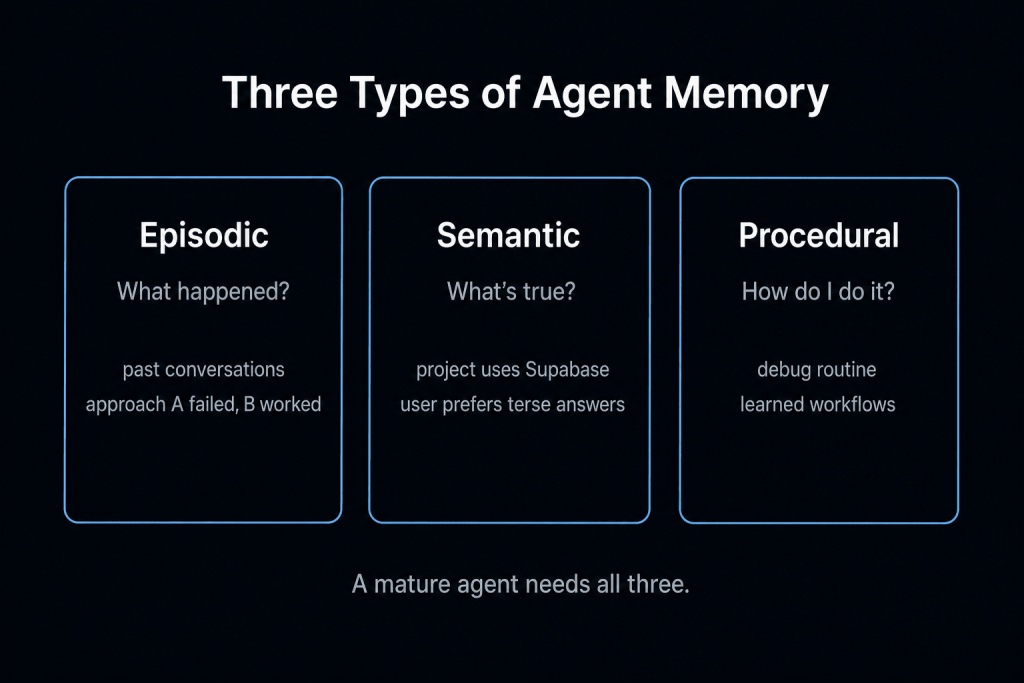
앤트로픽 연구팀이 AI 에이전트의 메모리 시스템 구성 요소를 구체적으로 정의한 보고서를 발표했습니다. 이번 문서는 대규모 언어 모델이 세션 종료 시 모든 정보를 잊어버리는 아키텍처적 한계를 지적하며, 이를 극복하기 위한 외부 메모리 계층의 필요성을 강조합니다.
연구진은 인지과학에서 차용한 분류 체계를 통해 에이전트 메모리를 에피소드, 의미론, 절차적 세 가지 유형으로 구분했습니다. 에피소드 메모리는 특정 경험과 사건을 기록하고, 의미론 메모리는 사실과 선호도 같은 지식을 저장합니다. 절차적 메모리는 Skills 형태로 나타나며, 사용자가 직접 작성하거나 학습 과정을 통해 형성됩니다.
메모리의 물리적 저장 형태는 토큰 수준으로 설명됩니다. 이는 읽을 수 있는 텍스트 형태의 데이터로, 사실, 요약문, 사용자 프로필 등이 포함됩니다. 이러한 데이터는 쓰기, 유지보수, 검색이라는 생명주기를 거치며 관리됩니다.
이 과정은 에이전트가 장기적인 작업을 수행할 때 일관성을 유지하는 핵심 메커니즘입니다.
기술 커뮤니티 Hacker News에서는 해당 주제에 대한 활발한 토론이 이어졌습니다. 일부 개발자들은 컨텍스트 윈도우가 과도하게 커질 경우 자동으로 다음 세션으로 전환되는 핸드로버 방식을 적용하고 있다고 밝혔습니다. 하지만 Claude Code 등 기존 도구가 생성하는 메모리의 대부분은 현재 작업에만 국한되어 불필요하다고 평가받았습니다.
사용자 피드백에 따르면 자동 생성된 메모리의 약 95%는 삭제 대상인 것으로 나타났습니다. 이는 메모리 생성 판단 기준이 아직 정교하지 못함을 시사합니다. 대신 과거 대화 로그를 DuckDB 등으로 분석하여 도구 호출 실패 패턴이나 캐시 미스 원인을 파악하는 방식이 더 효율적인 대안으로 제시되었습니다.
현재 에이전트 메모리 시스템은 MemGPT, Mem0, Claude Code 등 다양한 구현체들이 각기 다른 접근법을 취하고 있습니다. 하지만 공통적인 과제는 어떤 정보를 저장할지 결정하는 판단력 부족입니다. 연구는 진행 중이지만, 실제 운영 환경에서의 메모리 정제 및 최적화 기준은 여전히 개별 사용자의 설정에 의존하고 있습니다.