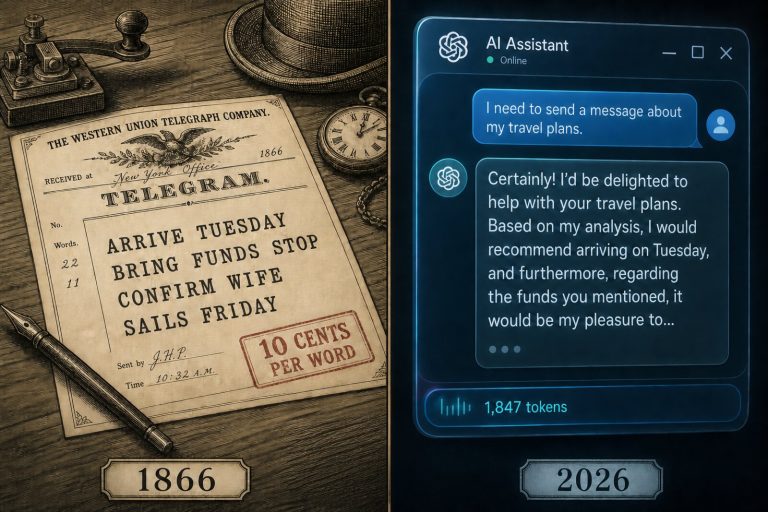
LLM에 1866년 전신 문체 적용 시 출력 토큰 40~49% 감소
트래비스 스미스가 공개한 벤치마크 테스트에서 대형 언어모델이 19세기 전신 통신의 압축된 문체를 따를 경우 API 과금 대상인 출력 토큰이 약 절반 수준으로 줄어드는 결과가 확인되었습니다.
JORE2
트래비스 스미스가 공개한 벤치마크 테스트에서 대형 언어모델이 19세기 전신 통신의 압축된 문체를 따를 경우 API 과금 대상인 출력 토큰이 약 절반 수준으로 줄어드는 결과가 확인되었습니다.
Ollaya가 LLM처럼 오픈 소스 결정 모델을 로컬에서 실행할 수 있는 도구를 공개했다. TypeSafe 호환 API를 지원하며 NVIDIA RTX 4090 기준 10ms 수준의 응답 속도를 제공한다.
Fly.io가 VSCode의 SSH 원격 편집 구조가 LLM 에이전트 실행 환경으로 부적합할 수 있다고 비판했다. 커뮤니티는 보안 통제 가능성을 반박하며 논쟁이 이어지고 있다.

에이전트가 스스로 학습한 경험을 재사용하는 방식이 주목받고 있습니다. IBM 연구진이 제안한 ALTK-Evolve 는 기존 ACE 와 달리 개별 가이드라인 형태로 지식을 저장해 토큰 소모를 획기적으로 줄였습니다. 같은 원리라…

거대 모델 중심의 AI 경쟁 속에서 14MB 크기의 경량화 모델 Needle2가 주목받고 있습니다. 스마트폰부터 웨어러블, 스마트홈 기기까지 저사양 하드웨어에서도 실시간 추론이 가능해지면서 온디바이스 AI의 패러다임이 바뀌고…

수천억 개의 파라미터를 가진 거대 언어 모델을 실용적인 크기로 압축하는 기술이 다시 주목받고 있습니다. 기존 방식의 막대한 연산 비용을 획기적으로 줄인 새로운 접근법이 등장하면서 기업들의 대규모 배포 장벽이 낮아질 전망입니다…

고성능 LLM 추론 시스템의 핵심인 vLLM 의 내부 구조가 상세히 공개되면서 개발자 커뮤니티의 이목이 집중되고 있습니다. 페이지드 어텐션과 연속 배치 같은 기술이 어떻게 작동하는지, 그리고 멀티 GPU 환경에서의 확장성까지…
브라질 리우데자네이루시가 공개한 초대규모 언어모델이 화제다. 현지 IT 기업이 자체 개발한 것으로 홍보했으나, 커뮤니티 분석 결과 기존 두 모델의 가중치를 단순 합친 것일 가능성이 제기되면서 기술 진정성에 대한 논란이 일고…
AI 모델의 컨텍스트 창 크기가 기하급수적으로 커지고 있지만, 실제 성능은 광고 수치의 절반도 미치지 못한다는 지적이 쏟아지고 있습니다. 개발자들이 느끼는 '지능형 구역'과 '무감각 구역'의 차이를 이해해야 하는 시점입니다.

모델이 커질수록 평가는 더 복잡해집니다. 기존 도구들은 완성된 모델 검증에 치중해 개발 중 반복되는 변화를 따라가지 못했습니다. 올모이 올린 새로운 워크벤치가 개발 루프의 비효율을 어떻게 해소하는지, 그리고 왜 지금 주목받는…