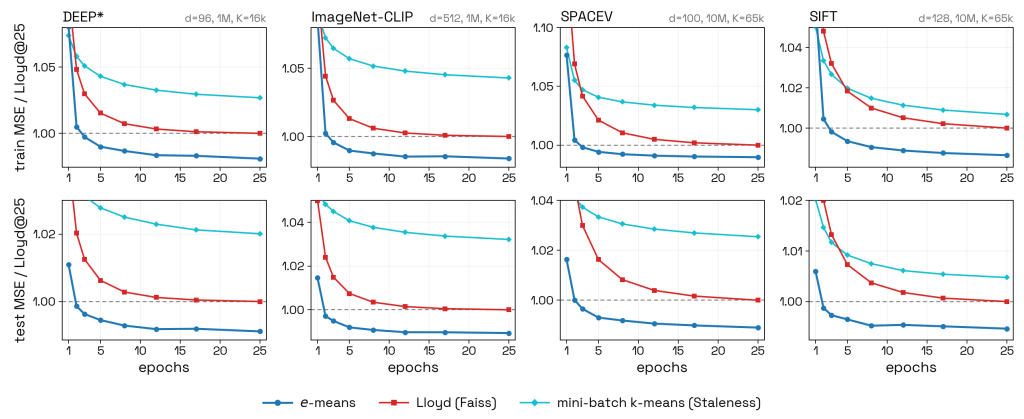
메타 FAIR 소속 연구팀이 새로운 클러스터링 알고리즘인 e-means를 개발하고 이를 오픈소스로 공개했습니다. 이번 프로젝트에는 피에르-에마뉘엘 마자레, 게르게 실바시, 위고 투브론 등 다수의 연구자가 참여했습니다. 이들은 기존 표준인 로이드 알고리즘을 대체할 수 있는 현대적인 최적화 규칙을 제시했습니다.
핵심 성과는 처리 속도와 정확도의 동시 개선입니다. 연구 결과에 따르면 e-means는 대규모 데이터셋과 다양한 스케일에서 로이드 알고리즘 대비 에폭 수와 실제 소요 시간 모두 약 10배의 가속 효과를 보였습니다. 특히 GPU 환경에서는 최신 구현체 대비 10배에서 45배까지 벽시계 시간이 단축되었습니다.
CPU 기반 Faiss 라이브러리와의 비교에서도 8배에서 15배의 성능 향상이 확인되었습니다.
기술적 배경은 미니배치 업데이트와 지수 이동 평균의 결합입니다. 전통적인 k-means는 전체 데이터를 한 번에 처리하는 방식이 주류였으나, e-means는 딥러닝에서 활용되는 현대적 도구들을 차용했습니다. 이를 통해 고정된 하이퍼파라미터 튜닝 없이도 문제 크기와 임베딩 데이터셋에 따라 감쇠율과 배치 크기를 결정하는 공식을 도출했습니다.
구체적인 수치로 보면 25 에폭 시점의 테스트 손실 값을 달성하기 위해 e-means는 1.2에서 3 에폭만 필요로 합니다. 이는 로이드 알고리즘이 97번의 업데이트를 수행하는 동안 e-means는 단 1번의 업데이트로 유사하거나 더 나은 결과를 낸다는 의미입니다. 100억 개의 DINO 임베딩 데이터를 1600만 개 클러스터로 분할하는 실험에서는 2.5 에폭 만에 로이드의 25 에폭 손실보다 낮은 값을 기록했습니다.
커뮤니티 반응은 사용 사례에 따라 갈렸습니다. 일부 개발자는 IVF 인덱스 적용 시 GPU에서 146배의 속도 향상을 경험했다고 보고했습니다. 반면 구 표면 메시지의 셀 중심을 계산하는 용도로 시도한 사용자들은 e-means가 오히려 느리고 노이즈가 많다고 지적했습니다.
이 경우 데이터셋이 없으므로 미니배치의 샘플링 오차가 불필요하게 작용했기 때문입니다.
현재 e-means는 정적 데이터셋의 클러스터링에 특화되어 있습니다. VQ-VAE 내부의 코드북 학습처럼 분포가 계속 변하는 동적 환경과는 구분됩니다. 연구팀은 이 알고리즘이 데이터 분석, 검색, 양자화 및 큐레이션 분야에서 기존 방법론의 대안이 될 수 있음을 시사했습니다.
다만 모든 상황에서 로이드 알고리즘을 완전히 대체할 수 있는지는 추가 검증이 필요합니다.