애플 머신러닝 연구팀이 검색 증강 생성 시스템의 효율성을 높이기 위한 최대 내적 곱 탐색 기법 연구를 공개했습니다. 이 연구는 추천 시스템과 검색 엔진의 핵심인 MIPS 처리 비용을 줄이는 데 초점을 맞춥니다.
기존 MIPS 방법은 수백만 개의 후보 벡터와 쿼리를 비교할 때 계산 부하가 급증하는 문제를 안고 있었습니다. 이를 해결하기 위해 클러스터링이나 양자화를 통해 정확도와 속도 간 균형을 맞추는 근사 기법이 주로 사용되었습니다.
하지만 이러한 기존 방법들은 쿼리와 키 벡터의 분포가 유사하다고 가정하거나 쿼리의 특성을 무시하는 경향이 있습니다. 애플은 이 가정이 RAG 환경에서는 문제가 될 수 있다고 지적합니다.
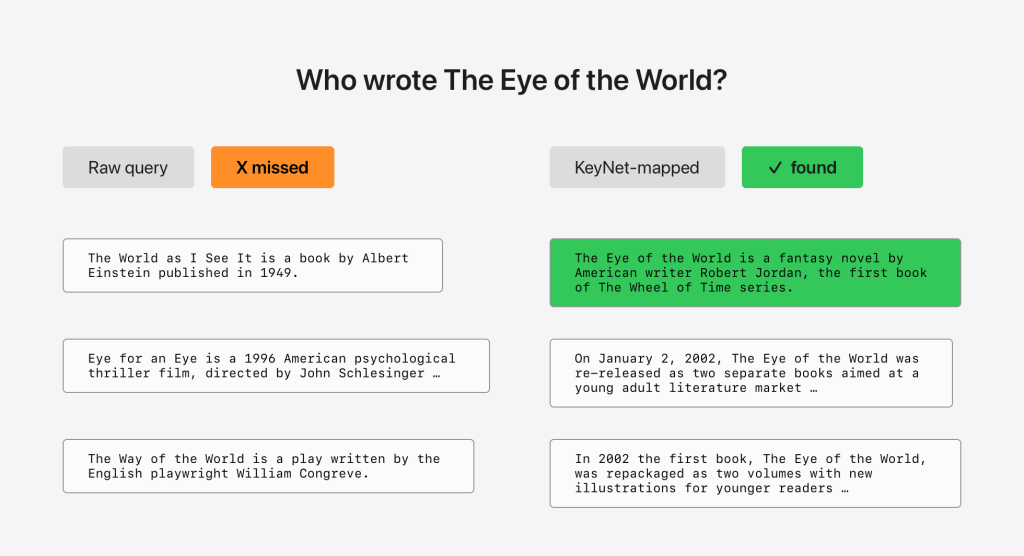
RAG에서는 사용자가 입력한 짧은 질문이 쿼리가 되고, 길고 정보가 풍부한 큐레이션된 텍스트가 키로 작용합니다. 두 데이터셋의 구조적 차이가 크기 때문에 일반적인 인덱싱 전략으로는 최적의 성능을 내기 어렵다는 설명입니다.
애플의 제안은 실제 배포 환경에서 안정적인 쿼리 분포를 활용하는 데 있습니다. 모든 가능한 입력에 대해 좋은 성능을 내기보다 예상되는 입력 소스에 맞춰 방법을 설계하면 컴퓨팅 자원을 더 효율적으로 배분할 수 있다는 논리입니다.
이 연구는 Hacker News에서 큰 주목을 받으며 기술 커뮤니티의 다양한 반응을 불러일으켰습니다. 일부 개발자들은 Spotify의 병렬 융합 라우터 같은 학습 기반 검색 방식을 언급하며 유사한 흐름을 짚었습니다.
그러나 실무 적용 가능성에 대한 회의론도 적지 않습니다. 수백만 건 이하의 데이터 규모에서는 BM25 인덱스와 LLM 도구를 결합하는 방식이 학습된 메서드보다 낫다는 경험담이 공유되기도 했습니다.
또 다른 의견은 임베딩 모델이 코드베이스나 복잡한 도메인을 이해하는 데 한계가 있어 단순 grep 검색보다 품질이 떨어질 수 있다는 점을 강조합니다. 이는 속도와 정확도 사이의 트레이드오프를 다시 생각하게 만듭니다.
한편 arXiv에 게재된 관련 연구는 사용자가 정확도와 비용 간의 균형을 직접 조절할 수 있는 프레임워크를 소개했습니다. 제어 파라미터를 통해 최소 비용 검색과 고정확도 검색 사이를 유연하게 오갈 수 있도록 설계되었습니다.
이처럼 RAG 검색 최적화 분야는 단순한 알고리즘 개선을 넘어 사용자 의도와 시스템 제약 조건을 어떻게 반영할 것인가로 논의가 확장되고 있습니다. 각 기업과 개발자는 자신의 데이터 규모와 질의 패턴에 맞는 전략을 선택해야 합니다.