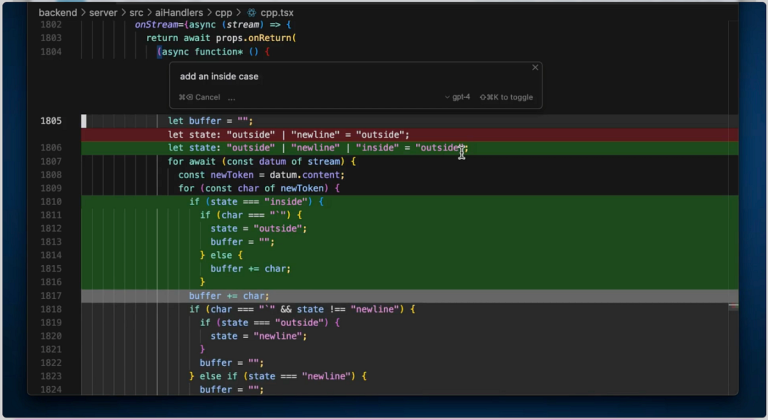
AI 코딩의 속도를 늦추는 역설: 왜 개발자들은 ‘천천히’ 쓰기를 선택하는가
대부분의 개발자가 AI 를 활용해 저품질 코드를 빠르게 쏟아내는 것을 목표로 삼았지만, 최근엔 정반대의 흐름이 주목받고 있습니다. 속도를 희생하더라도 여러 모델을 교차 검증하며 버그를 찾아내고, 유지보수가 쉬운 코드를 완성하…
JORE2
대부분의 개발자가 AI 를 활용해 저품질 코드를 빠르게 쏟아내는 것을 목표로 삼았지만, 최근엔 정반대의 흐름이 주목받고 있습니다. 속도를 희생하더라도 여러 모델을 교차 검증하며 버그를 찾아내고, 유지보수가 쉬운 코드를 완성하…

기존 SaaS 기반 프레젠테이션 툴의 구독료 부담과 데이터 유출 우려를 해결할 대안이 등장했습니다. 오픈소스 기반의 AI 프레젠테이션 생성기 Presenton이 글로벌 개발자 커뮤니티에서 급부상하며 주목받고 있습니다.
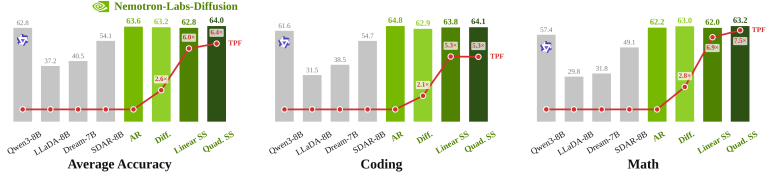
기존 대규모 언어모델이 직면한 순차적 생성의 병목 현상을 해결할 새로운 패러다임이 등장했다. 나이비디아의 확산형 언어모델이 어떻게 메모리 대역폭 문제를 우회하며 초고속 추론을 가능하게 하는지, 그리고 이것이 개발자 워크플로우…
트랜스포머 모델 학습의 속도를 결정짓는 핵심 병목이 단순한 연산이 아닌 데이터 이동에 있다는 사실, CODA가 이를 GEMM 연산의 끝부분에 통합해 해결하며 AI 개발 패러다임을 바꾸고 있습니다.

고성능 로컬 LLM 구축을 꿈꾸는 사용자들에게 AMD 멀티 GPU 구성은 매력적이지만, 드라이버 충돌과 호환성 문제로 고전하는 사례가 늘고 있습니다. 내장 그래픽 비활성화라는 의외의 해결책을 통해 안정성을 확보한 사례는 단순…

최근 6 개월 동안 대형 언어 모델의 성능 순위가 5 번이나 뒤바뀌며 개발자들 사이에서 큰 파장을 일으켰습니다. 특히 2025 년 11 월을 기점으로 코딩 에이전트의 실력이 비약적으로 성장했는데, 이는 단순한 마케팅 수사가…

거대 언어 모델이 긴 대화 맥락을 유지하기 위해선 막대한 메모리가 필요하다는 통념을 깨는 새로운 접근법이 등장했습니다. 단순한 컨텍스트 확장이 아닌, 고정된 크기의 상태 행렬로 과거 정보를 압축하는 Δ-Mem 기술이 글로벌…
소규모 하드웨어에서 대형 언어 모델을 구동하는 DS4 런타임이 주목받으며, AI 산업의 패러다임이 '최고 성능'에서 '충분한 지능'으로 이동하고 있다. 고비용 모델의 비즈니스 모델이 흔들릴 수 있는 시기가 왔음을 시사한다.

LLM과 AI 에이전트의 등장으로 소프트웨어 개발 장벽이 낮아지면서, 사용자들이 범용 상용 앱 대신 자신만의 환경을 구축하는 '에마스화' 현상이 글로벌 기술계를 강타하고 있다. 이는 단순한 취향의 문제를 넘어, 표준화된 도구…

단 3 개월 만에 깃허브 스타 14 만 개를 돌파하며 오픈소스 에이전트 시장을 장악한 헤르메스가 주목받고 있습니다. 외부 모델에 의존하지 않고 스스로 기술을 습득하고 개선하는 자율성, 그리고 RTX 기반 로컬 환경에서 안정적…