Ollaya가 오픈 소스 결정 모델을 로컬 환경에서 실행할 수 있는 도구를 공개했다. 이 프로젝트는 대형 언어 모델 실행 도구인 Ollama와 유사한 방식으로 작동한다. 사용자는 자신의 하드웨어에서 Laya, decider, NLI, GLiClass 같은 결정 모델을 직접 가져와 서빙할 수 있다.
핵심 기능은 TypeSafe 호환 API 제공이다. Ollaya는 /v1/systemone과 /v1/models 엔드포인트를 통해 TypeSafe의 요청 및 응답 형식을 그대로 지원한다. 공식 TypeSafe Python SDK 0.7.1 버전은 별도 수정 없이 로컬 서버와 연동된다.
이를 통해 개발자는 기존 워크플로우를 유지하면서 로컬 추론 환경을 구축할 수 있다.
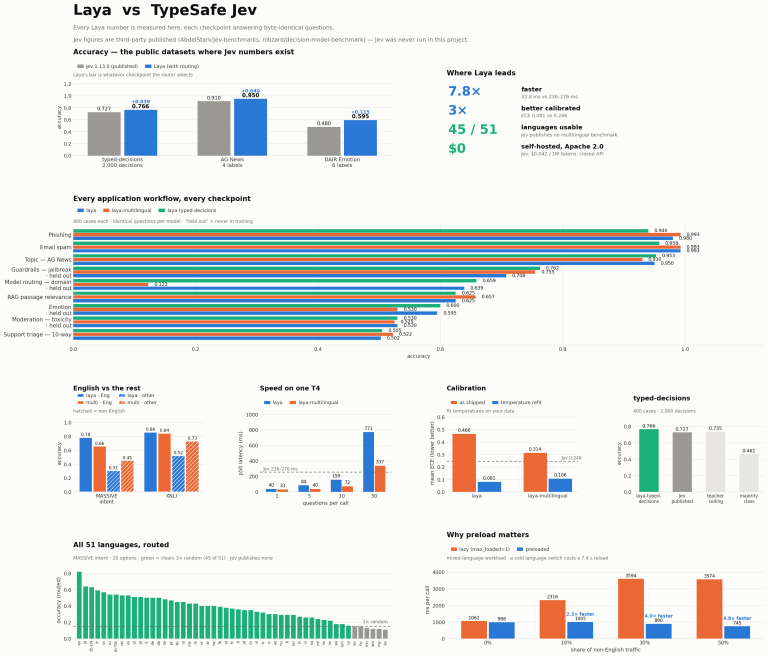
성능 측면에서는 단일 순방향 패스로 답변을 생성하는 방식이 특징이다. 토큰 단위 생성이 아니라 한 번의 계산으로 결과를 도출한다. NVIDIA RTX 4090 GPU에서 fp16 정밀도의 Laya 모델을 사용할 경우, 5개 질문 요청의 중간값 지연 시간은 HTTP API를 통해 약 10ms로 측정됐다.
이는 네트워크 지연을 포함한 호스팅 API 벤치마크와 비교할 때 자릿수 단위의 차이를 보인다.
지원하는 모델들은 용도에 따라 구분된다. Laya는 Convai Innovations가 개발한 모델로 가장 빠른 속도를 제공한다. decider는 Mapika가 Qwen3.5 기반으로 만든 디코더 모델로 오픈 소스 중 가장 높은 정확도를 기록한다.
von은 최대 8,192 토큰까지 처리할 수 있으며, qwen3guard는 Qwen 팀이 개발한 안전성 검사 모델이다.
Hacker News 커뮤니티에서는 이 프로젝트에 대한 다양한 반응이 확인된다. 일부 사용자는 Laya가 Jev의 호스팅 서비스보다 복잡한 쿼리에서 신뢰도가 낮고 오류가 많다고 지적한다. 반면 오픈 소스 생태계의 빠른 복제 속도와 소비자 잉여 창출 가능성에 주목하는 의견도 있다.
현재 Ollaya는 GitHub와 공식 웹사이트를 통해 배포되고 있다. 로컬 실행을 원하는 사용자는 NVIDIA GPU 등 적절한 하드웨어 환경을 갖춰야 한다. 모델별 정확도와 속도 데이터는 공식 모델 페이지에서 상세히 확인할 수 있다.
작성자 소개