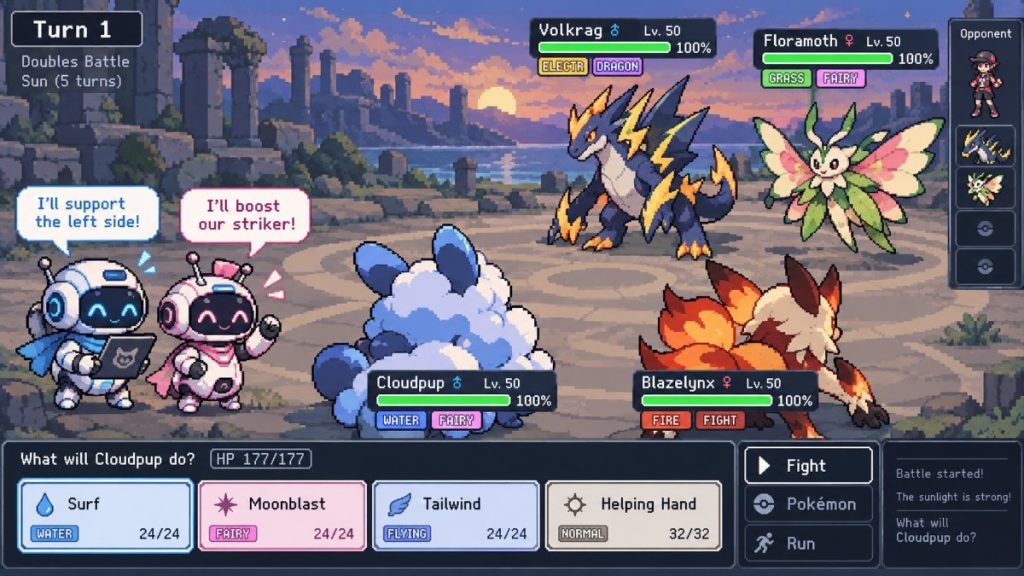
올리버 그라브너가 포켓몬 쇼다운의 2대2 대전 형식에서 두 개의 대규모 언어 모델 에이전트가 협력하는 환경을 공개했습니다. 이 프로젝트는 GitHub 저장소 multi-agent-poke-showdown으로 배포되었습니다.
기존의 다중 에이전트 연구 대부분은 작업이 파이프라인을 따라 전달되는 워크플로우에 집중되어 있었습니다. 그라브너는 이러한 접근법과 달리, 완전한 정보가 제공되지 않는 게임 이론적 환경에서 에이전트들이 어떻게 소통하고 행동을 조율하는지 측정하기 위해 이번 실험을 설계했습니다.
실험에서는 네 명의 플레이어가 각각 세 마리 팀 중 한 마리를 통제합니다. 양쪽 진영에 두 명씩 배정되며, 각 턴마다 에이전트는 전투 상황을 평문으로 요약하여 받습니다. 또한 사용 가능한 기술 목록도 함께 제공됩니다.
에이전트는 기술을 선택하기 전에 파트너에게 비공개 메시지를 보낼 수 있습니다. 예를 들어 상대가 물 타입일 경우 불꽃 기술이 저항받는다는 점이나, 특정 기술로 기절 효과를 노리는 등의 전략적 판단을 공유합니다.
포켓몬 더블 배틀은 상대의 구성이 숨겨져 있고 데미지가 랜덤하게 결정되는 구조입니다. 따라서 승리하려면 상대 팀을 파악하고 타겟을 분산하며 파트너와의 호흡을 맞추는 고도의 전략이 필요합니다.
최근의 PokéAgent Challenge 같은 벤치마크에서는 한 쪽을 단일 에이전트가 담당했습니다. 하지만 전문 강화 학습 에이전트가 일반 LLM보다 더 잘 싸우는 경향이 있어, 동료 간의 협응 능력을 테스트하기에는 부족했습니다.
그라브너의 환경은 공식 포켓몬 쇼다운 시뮬레이터를 Gym 스타일로 감싸 구현되었습니다. 이를 통해 LLM 에이전트들의 협응 수준을 통제된 조건에서 측정할 수 있게 되었습니다.
향후 이 데이터는 강화 학습을 통해 협업 행동을 장려하는 훈련 자료로 활용될 가능성이 언급되었습니다. 다만 현재 단계에서는 단순한 평가 환경 구축에 초점이 맞춰져 있습니다.
커뮤니티 반응으로는 팀 선택 방식이 무작위인지, 실제 랭크전에서 인간 플레이어와 얼마나 경쟁력 있는지에 대한 질문이 제기되었습니다. 또한 데미지 계산 시 아이템이나 특성으로 인한 변동성을 고려했는지 여부도 관심사였습니다.
현재까지 보고된 구체적인 승률 수치나 성능 지표는 공개되지 않았습니다. 실험의 핵심은 대화라는 메커니즘이 추가 추론 과정의 대리 지표 역할을 하는지 규명하는 데 있습니다.