구글이 새로운 오픈소스 멀티모달 임베딩 모델인 EmbeddingGemma 2를 공식 공개했습니다.
이 모델은 텍스트, 코드, 이미지, 비디오, 오디오 등 다양한 형식의 데이터를 768차원의 단일 벡터 공간으로 변환합니다.
기존 Gemma 4 기반의 서브 1B 파라미터 규모로 설계되어 컴퓨팅 자원 부담을 크게 줄였습니다.
특히 검색 증강 생성(RAG) 애플리케이션이나 로컬 코드베이스 인덱싱 작업에 최적화되었습니다.
높은 정확도와 낮은 지연 시간을 동시에 확보할 수 있도록 튜닝된 점이 특징입니다.
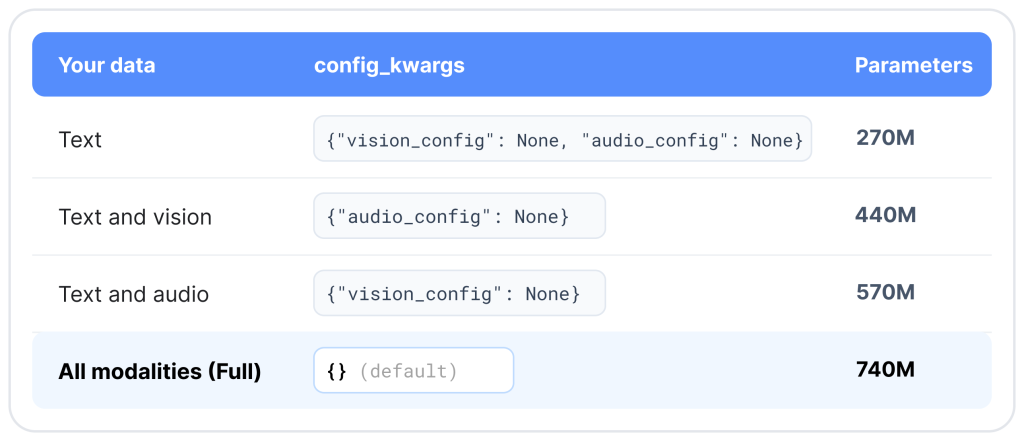
개발자들은 sentence-transformers 라이브러리를 통해 필요한 모달리티 인코더만 선택적으로 로드할 수 있습니다.
텍스트와 코드 전용으로는 270M 파라미터가 사용됩니다.
비전 기능까지 포함하면 440M, 오디오는 570M 파라미터가 소요됩니다.
모든 모달리티를 지원할 경우 최대 740M 파라미터가 할당됩니다.
Matryoshka Representation Learning(MRL) 기술도 적용되었습니다.
이를 통해 벡터 차원을 768에서 128까지 동적으로 잘라낼 수 있습니다.
벡터 데이터베이스 저장 공간을 대폭 절약할 수 있는 장점이 생겼습니다.
256차원 수준에서도 텍스트와 코드 검색 품질의 상당 부분을 유지하는 것으로 보고되었습니다.
Apache 2.0 라이선스로 배포된 점이 개발자 커뮤니티의 호응을 얻고 있습니다.
Hacker News에서는 독점 모델 의존성을 피하고 프라이버시 중심의 사용을 가능하게 한다는 평가가 나왔습니다.
특정 벤더가 서비스를 중단하더라도 자체 호스팅이 가능하다는 안정성 측면이 강조되었습니다.
현재까지의 검증된 정보는 공식 블로그와 개발 가이드에 집중되어 있습니다.
실제 대규모 프로덕션 환경에서의 장기적인 성능 저하나 유지보수 비용에 대한 구체적인 데이터는 아직 공개되지 않았습니다.