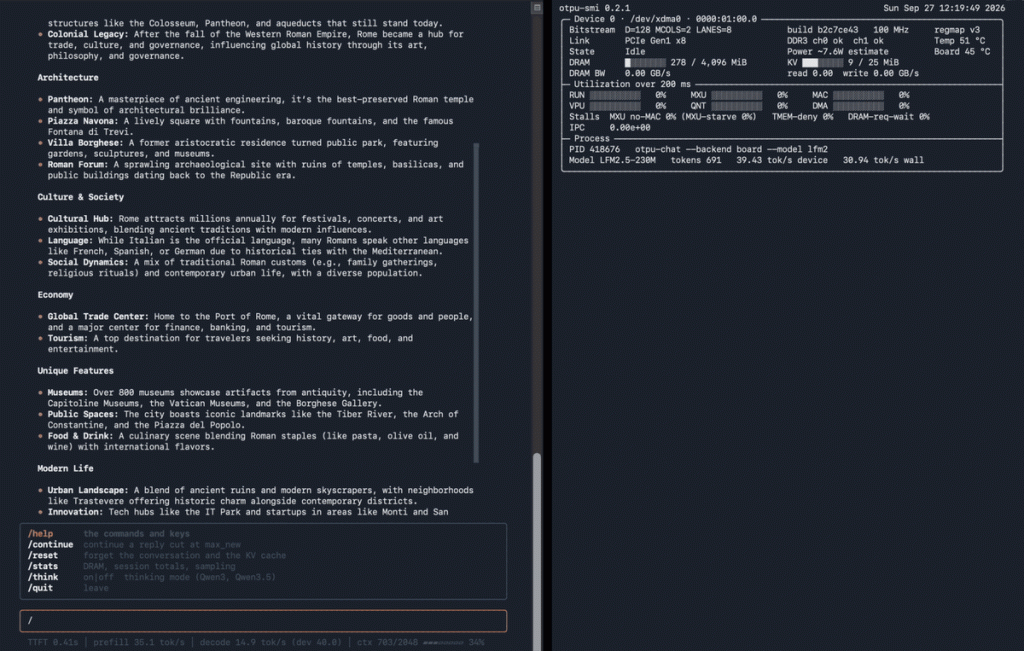
FeSens 팀이 GitHub에 공개한 openTPU 저장소는 인공지능이 직접 설계한 추론 가속기 프로젝트입니다. 이 프로젝트는 시스템 버릴로그 기반의 RTL, 자체 명령어 세트 아키텍처, 비트 정확도 시뮬레이터, 커널 컴파일러, 그리고 프로파일링 도구인 렌즈까지 하나의 저장소에 담았습니다.
가장 눈에 띄는 점은 하드웨어와 소프트웨어 스택 전체가 AI 도구를 활용해 개발되었다는 사실입니다. README 파일에는 ‘인공지능이 개발한 오픈소스 AI 가속기’라는 문구가 명시되어 있습니다. 이는 단순한 코드 생성을 넘어 칩 설계 과정 자체에 AI가 개입했음을 시사합니다.
실제 구동 환경은 제한적입니다. 이 가속기는 자일링스 Kintex-7 xc7k480t FPGA가 장착된 인스퍼 YPCB-00338 PCIe 카드를 타겟으로 합니다. 메모리 구성은 두 채널의 DDR3-1066 규격이며 총 용량은 4 GiB에 불과합니다.
이러한 하드웨어 제약 속에서 Qwen3, LFM2.5, Qwen3.5 같은 소형 언어 모델들이 실행됩니다.
Hacker News 커뮤니티에서는 이 프로젝트에 대한 활발한 논의가 이어졌습니다. 한 사용자는 왜 대형 연구소들이 최전선 모델을 칩에 직접 굽지 않는지 질문을 던졌습니다. 이에 대해 다른 참여자는 AI가 SOTA 모델을 생산할 수 있는 가속기를 이미 만들어냈으며, 다음 단계는 메모리 대역폭 문제를 해결하는 것이라고 분석했습니다.
특히 주목할 만한 주장은 재귀적 자기 개선 루프에 관한 것입니다. 초기에는 초당 몇 개의 토큰만 생성하던 시스템이 반복적인 최적화 과정을 통해 소형 모델 기준 초당 80개 이상의 토큰을 처리하게 되었다는 설명이 등장했습니다. 하지만 이는 검증된 공식 성능 지표라기보다 커뮤니티 내 관찰과 해석의 영역에 가깝습니다.
현재 openTPU는 Gemma 4 등 최신 모델 지원 가능성을 언급하고 있으나, 실제 배포 버전의 안정성과 확장성은 여전히 의문으로 남아 있습니다. FPGA 기반의 유연성을 활용하여 모델 아키텍처 자체를 재구성하는 실험적 시도들도 거론되지만, 구체적인 구현 사례는 확인되지 않았습니다.
프로젝트의 실용적 가치는 오픈소스 생태계 내에서 AI 주도 하드웨어 설계의 가능성을 탐구하는 데 있습니다. 다만 4 GiB의 메모리와 구형 DDR3 규격은 대규모 추론 작업에는 명백한 병목 지점으로 작용합니다. 향후 더 높은 대역폭의 메모리 인터페이스나 새로운 FPGA 플랫폼으로의 이식이 필수적인 과제로 제시되고 있습니다.