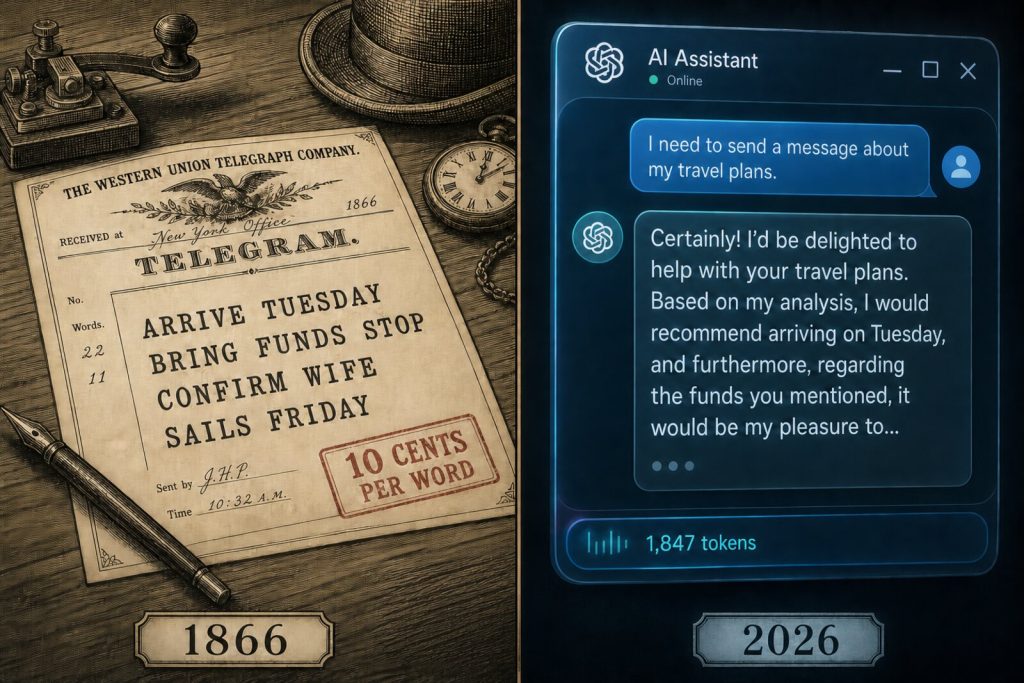
개발자 트래비스 스미스가 지난 10월 4일, 대형 언어모델이 1866년 전신 통신 방식인 케이블시를 모방할 때 발생하는 토큰 절감 효과를 측정하는 Telegraph Test 벤치마크를 공개했습니다. 이 실험은 모델에게 특정 지시문을 주어 과거 전신 오퍼레이터들이 사용했던 압축된 문체로 답변하게 하고, 그 결과 생성되는 출력 토큰의 양과 정보 복구 정확도를 비교합니다.
측정 결과에 따르면 여러 모델 계열에서 유료 API 요금 산정의 기준이 되는 출력 토큰 수가 40퍼센트에서 49퍼센트까지 감소했습니다. 이는 현대적인 서술적 문장을 제거하고 명사, 동사, 숫자 등 핵심 요소만 남기는 방식으로 응답을 구성했을 때 나타나는 현상입니다. 동시에 모델들은 압축된 텍스트에서도 원래 질문에 대한 정보를 완전한 충실도로 다시 추출해내는 능력을 유지했습니다.
케이블시는 19세기 대서양 횡단 해저 케이블 부설 이후 형성된 통신 관습에서 유래했습니다. 당시 전신 회사는 단어 단위로 요금을 부과했으며, 10단어당 10달러라는 높은 비용 구조가 존재했습니다. 이에 대응하기 위해 기업들은 사전 형식의 코드북을 사용하거나, 접속사와 관사를 생략한 채 주술 목적어 순서로만 문장을 구성하는 케이블시 문법을 발전시켰습니다.
이러한 압축 전략은 매체의 물리적 한계와 경제적 비용 때문에 자연스럽게 진화한 결과였습니다.
스미스는 이번 테스트에서 두 가지 압축 전략을 현대 LLM에 적용해 보았습니다. 하나는 과거의 코드북처럼 특정 문구를 단일 단어로 치환하는 방식이고, 다른 하나는 케이블시처럼 문법적 장식을 제거하는 방식이었습니다. 데이터 분석 결과, 단순 치환보다는 문장 구조 자체를 간결하게 만드는 케이블시 접근법이 더 큰 효율성을 보여주었습니다.
다만 일부 커뮤니티에서는 벤치마크의 평가 기준이 모델의 자연스러운 표현 다양성을 제한할 수 있다는 지적도 제기되었습니다.
현재 GitHub에는 해당 실험을 재현할 수 있는 하네스와 고정된 데이터 원장이 공개되어 있습니다. 개발자들은 프롬프트에 1866년 전신 스타일을 명시적으로 요구함으로써 추론 비용을 낮출 수 있는 가능성을 확인했습니다. 그러나 법적 문서나 의료 기록처럼 미묘한 뉘앙스가 중요한 분야에서는 이러한 극단적 압축이 정보 손실을 초래할 수 있어 적용 범위에 대한 추가 검증이 필요합니다.