클라우드 인프라 제공업체인 Ubicloud가 자체 블로그를 통해 vLLM 최신 버전의 기능 업데이트 내용을 공개했습니다. 이번 발표는 오픈 웨이트 대형 언어 모델을 서빙할 때 자주 발생하던 툴 호출 정확도 문제를 다루고 있습니다.
기존 vLLM 0.28 버전을 사용할 경우 Kimi K2.6 모델의 툴 호출 스키마 준수율은 약 92%에 머물렀습니다. 이는 시도된 툴 호출 중 25건당 2건꼴로 실패한다는 의미입니다. 부정확한 툴 호출은 에이전트 워크로드에서 불필요한 컨텍스트를 누적시켜 최종 응답 품질을 떨어뜨리는 주요 원인이었습니다.
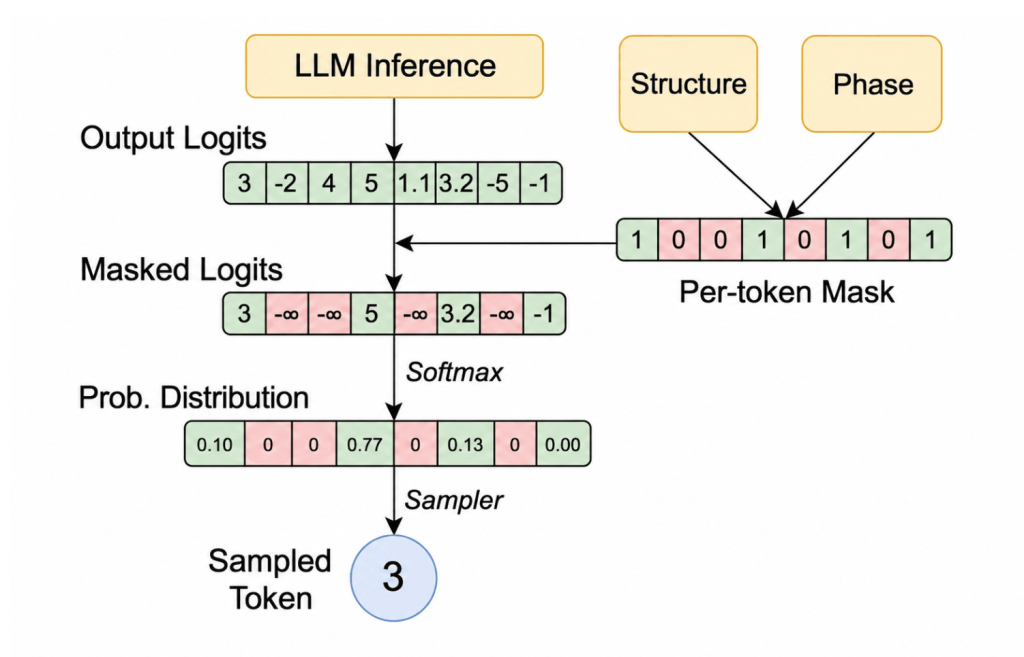
Ubicloud 팀은 이러한 문제를 해결하기 위해 vLLM의 포크 버전을 유지하며 자체적으로 대응해 왔습니다. 하지만 vLLM 0.31 버전이 공식적으로 제약 디코딩 지원 기능을 추가하면서 상황이 달라졌습니다. 이 기능은 모델이 출력하는 토큰이 정의된 JSON 스키마를 반드시 따르도록 강제합니다.
제약 디코딩은 추론 엔진 단계에서 모델의 생성 과정을 제한하는 기술입니다. 이를 활성화하면 Kimi와 DeepSeek 같은 최신 모델에서도 툴 호출 스키마 준수율을 100%까지 끌어올릴 수 있다고 보고되었습니다. 서버 측 플래그 설정만으로 적용 가능하다는 점이 실무적 장점으로 꼽힙니다.
Hacker News 커뮤니티에서는 이 소식에 대해 다양한 반응이 이어졌습니다. 한 사용자는 제약 디코딩이 이미 오래전부터 vLLM에 존재했던 기능이라고 지적하기도 했습니다. 다만 이전에는 기본값으로 비활성화되어 있거나 설정 방식이 복잡해 실제 운영 환경에서는 제대로 활용되지 못했던 것으로 보입니다.
또 다른 댓글에서는 도구 호출 형식이 업계 표준으로 완전히 정착하지 못한 점을 우려했습니다. OpenAI 스타일의 채팅 메시지 포맷과 다른 구조를 사용하는 모델들이 혼재되어 있어 일관된 제약을 적용하기 어렵다는 설명입니다. 일부 프로바이더들은 여전히 낮은 성능을 보이고 있다는 비판도 제기되었습니다.
Bohdan Hordii의 기술 분석 글은 툴 호출 실패의 구체적인 원인들을 짚어냈습니다. 채팅 템플릿 불일치, 런어웨이 토큰 생성, 스트리밍 델타 파편화 등이 대표적인 문제 사례로 제시되었습니다. 특히 Jinja 템플릿의 줄바꿈이나 이스케이프 문자 하나가 JSON 추출기를 무너뜨릴 수 있다고 경고했습니다.
이번 업데이트는 자율형 멀티 에이전트 시스템을 구축하는 개발자들에게 중요한 시사점을 줍니다. 데이터 주권과 예측 가능한 지연 시간을 위해 셀프 호스팅을 선택한 경우에도 이제 안정적인 툴 호출 환경을 구성할 수 있게 되었습니다.
다만 모든 모델이 즉시 100% 정확도를 보장하는 것은 아닙니다. 특정 모델 아키텍처나 복잡한 중첩된 툴 호출 구조에서는 여전히 검증이 필요합니다. Ubicloud는 벤치마크 테스트를 통해 회귀 현상을 지속적으로 추적하고 있다고 밝혔습니다.
개발자들은 vLLM 0.31 이상 버전으로 업그레이드 후 관련 서버 플래그를 명시적으로 활성화해야 합니다. 기존 설정 파일을 그대로 유지할 경우 새로운 기능이 적용되지 않을 수 있기 때문입니다. 각 모델의 트레이닝 방식에 따라 최적의 파라미터 값을 찾는 과정도 병행되어야 합니다.